125167, г. Москва, вн.тер.г. муниципальный округ Хорошевский, пр-кт Ленинградский, д. 37, помещ. 35/14
Реквизиты
ООО "АППТИМИЗМ"
ИНН 7725428484
Юридический адрес
125167, г. Москва, вн.тер.г. муниципальный округ Хорошевский, пр-кт Ленинградский, д. 37, помещ. 35/14
Адрес для корреспонденции
430005, РМ, г. Саранск, ул. Советская, д. 75, оф. 404
ОКВЭД
62.01 (основной)
Дополнительные виды ОКВЭД
62.02, 62.09, 63.11, 63.12
Виды деятельности в области ИТ (Приказ Минцифры № 449):
Код 1.01 — Проектирование, обследование, разработка, адаптация, модификация, модернизация, обновление, установка, интеграция, настройка, внедрение, сопровождение, тестирование и техподдержка ПО и баз данных.
Код 1.05 - Проектирование и (или) иная деятельность, а также оказание услуг в отношении сайтов или страниц сайтов в информационно-телекоммуникационной сети, включая информационно-телекоммуникационную сеть "Интернет".
Код 4.01 - Комплексное обслуживание ИТ-инфраструктуры, организация удаленного доступа заказчика к ИТ-инфраструктуре, включая: администрирование прав доступа, учетных записей пользователей, аппаратной платформы ИТ-инфраструктуры, баз данных, систем мониторинга, выполнение системных настроек, получение обновлений, их установка и (или) сопровождение установки; обеспечение сетевой доступности; резервное копирование; выполнение плановых и внеплановых восстановлений; осуществление миграции (переноса) данных.
Управление данными в компании: DWH, ETL, OLAP и BI без магии и маркетинга
Автор статьи: Георгий Полищук
Статья
Анализ
ETL
20.01.2026
У большинства компаний сейчас данных уже больше, чем когда-либо: ERP, CRM, DMS, SFA, интернет-каналы, маркетинговая аналитика, отчёты партнёров и сетей в Excel.
При этом базовые вопросы часто остаются без ответа: Если среди источников есть партнерская отчетность, система для дистрибьюторов помогает стандартизировать продажи, остатки и справочники до загрузки в DWH.
Какие продукты действительно зарабатывают деньги?
Где мы теряем продажи из-за нехватки товара, а где «замораживаем» деньги в запасах?
Какие промо работают, а какие просто «съедают» маржу?
Можно ли доверять отчётам хотя бы на 90%?
Проблема почти никогда не в «недостатке отчётов». Гораздо чаще её источник — отсутствие системного управления данными: нет единого хранилища (DWH), неуправляемые ETL-процессы, OLAP-кубы и BI-дашборды живут своей жизнью, а поверх этого появляются модные слова Big Data, Data Lake, data pipelines, которые не связаны с реальными задачами бизнеса. Для FMCG mdm система управления мастер-данными нужна уже на раннем этапе: без единых справочников DWH и BI быстро начинают показывать разные версии продаж.
В этой статье разберёмся:
что такое DWH, ETL, OLAP, BI, MDM, Big Data и Data Lake простыми словами;
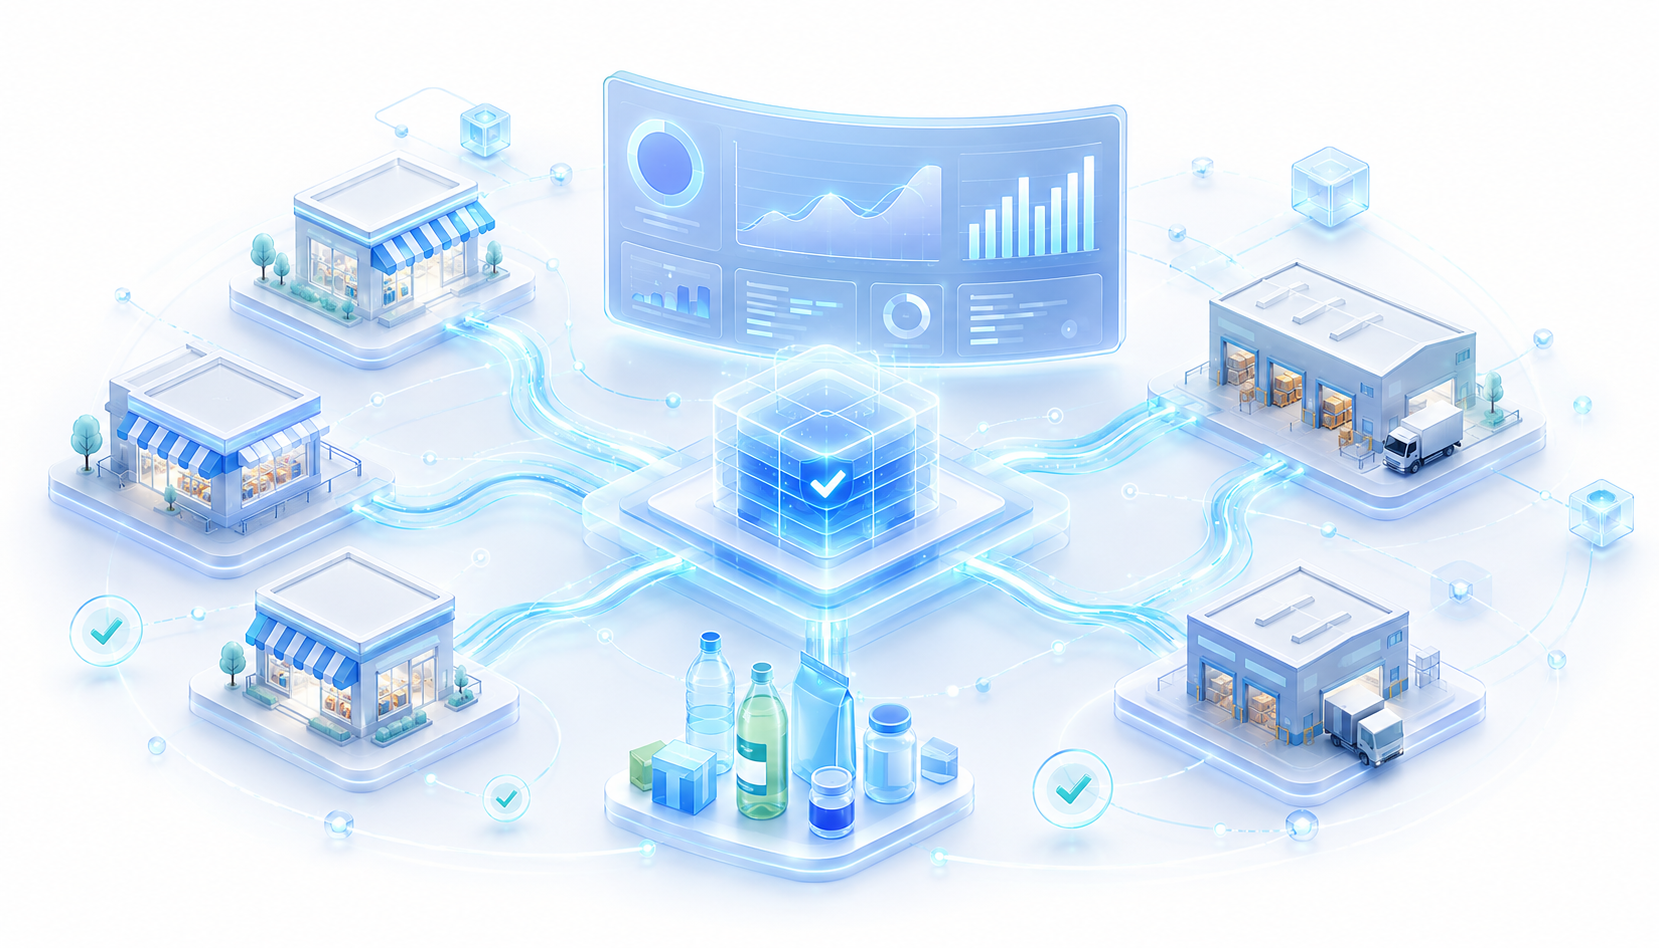
как эти элементы складываются в архитектуру управления данными;
с чего начинать, если сейчас всё держится на «Excel + отчёты из разных систем»;
какие ошибки чаще всего ломают проекты по данным;
как может выглядеть реалистичная дорожная карта развития.
В конце — FAQ с пояснениями ключевых терминов.
1. Разбираемся в терминах: DWH, ETL, OLAP, BI, MDM, Big Data
1.1. DWH (Data Warehouse) — корпоративное хранилище данных
Простыми словами DWH — это центральное хранилище, куда стекаются данные из разных систем, очищаются, приводятся к единому виду и хранятся так, чтобы по ним можно было быстро и предсказуемо строить отчёты и аналитику.
Для тех, кто глубже в теме
DWH — это отдельно стоящий аналитический контур, отличающийся от операционных баз (OLTP) по структуре и типу нагрузки.
Типичные подходы к моделированию: звёздная / «снежинка»-схема, Data Vault, корпоративная модель..
Хранилище часто делят на слои:
staging (сырой слой);
интеграционный слой (единые сущности);
витрины данных (data marts) под конкретные задачи: продажи, запасы, промо, полевые команды и т.д.
1.2. ETL (Extract–Transform–Load) — конвейер обработки данных
Простыми словами ETL — это автоматический конвейер, который:
забирает данные из источников (Extract),
очищает, стандартизирует и преобразует их (Transform),
загружает в хранилище или витрины (Load).
Когда спрашивают «что такое ETL-системы простыми словами» или «что такое ETL-обработка данных», речь именно об этой схеме. Для практиков
ETL-процессы должны быть:
автоматизированы (расписание, триггеры событий);
наблюдаемы (логи, мониторинг, алерты);
идемпотентны (повторный запуск не плодит дубли).
В современных архитектурах всё чаще используют ELT (Extract–Load–Transform): данные сначала загружаются в мощное хранилище или Data Lake, а трансформации выполняются уже внутри него.
Простыми словами OLAP — это способ организации данных и запросов, который позволяет:
быстро строить многомерные отчёты;
«крутить» показатели в разных разрезах (по времени, продуктам, клиентам, регионам, каналам);
проваливаться от агрегированных уровней до отдельных транзакций.
OLAP-куб — это многомерная модель данных:
измерения: время, клиенты, товары, каналы, регионы;
меры: продажи, маржа, остатки, количество визитов, KPI.
Задача OLAP — обеспечить высокую скорость агрегирующих запросов и удобство для интерактивной аналитики.
1.4. BI (Business Intelligence) — аналитика для людей
Простыми словами BI-система — это то, что видит пользователь: дашборды, графики, отчёты, конструкторы запросов. Ключевые моменты
BI — это не только «красивые отчёты», а единая среда принятия решений.
Если под BI нет нормального DWH, ETL и MDM, система превращается в набор несогласованных картинок, где одни и те же показатели дают разные значения.
1.5. MDM (Master Data Management) — управление мастер-данными
Простыми словами MDM отвечает за «словарь бизнеса»:
какие у компании продукты и как они кодируются;
какие есть клиенты и торговые точки;
какие используются каналы, форматы, иерархии.
Зачем это нужно
устранить дубли;
согласовать справочники между системами;
обеспечить единый источник правды для всех аналитических витрин и отчётов.
Без MDM даже идеальные DWH и ETL будут работать с «красивым хаосом»: отчёты не сойдутся, а споры о цифрах станут нормой.
1.6. Big Data и Data Lake
Big Data — это данные, которые характеризуются:
большим объёмом (миллиарды строк, терабайты и больше),
высокой скоростью поступления (потоки событий, обновления «почти онлайн»),
большим разнообразием форматов (таблицы, JSON, логи, события, медиа).
Для таких сценариев используют Data Lake — хранилище сырых данных, куда информация складывается «как есть». Над озером строятся ETL/ELT-пайплайны, которые формируют:
структурированные витрины и DWH для управленческой отчётности;
наборы данных для Data Science и продвинутых моделей.
Примеры:
прогноз спроса на основе истории продаж + логов промо + данных о погоде и событиях;
выявление аномалий в продажах и остатках по потоковым событиям, а не только по «снимку раз в день».
На практике DWH и Data Lake дополняют друг друга: Data Lake хранит всё в исходном виде, DWH остаётся официальным источником управленческой аналитики.
2. Зачем вообще нужна архитектура данных: взгляд бизнеса и ИТ
2.1. Что важно бизнесу
Бизнесу не так интересно, какая СУБД используется и на чём написан ETL. Волнуют другие вопросы:
Можно ли ежедневно видеть продажи, остатки и ключевые KPI по всем каналам?
Можно ли доверять отчётам, или всё равно приходится «пересчитывать в Excel»?
Можно ли понимать не только «что случилось», но и почему и что будет, если изменить цену, промо или ассортимент?
Архитектура данных нужна не ради технологий, а ради того, чтобы решения перестали приниматься вслепую.
2.2. Что важно ИТ и аналитике
С точки зрения ИТ и аналитиков:
источников становится больше, они разнородные и часто меняются;
интеграции множатся, но слабо документированы;
«скрипты на коленке» перестают масштабироваться.
Системная архитектура (DWH + ETL/ELT + OLAP + BI + MDM и при необходимости Data Lake):
упорядочивает потоки данных;
снижает риски и стоимость сопровождения;
делает развитие аналитики управляемым.
3. С каких данных и систем начинать
Классический тупик: «Сначала соберём все данные, потом начнём проект». Обычно так проекты никогда не заканчиваются.
Гораздо эффективнее начать с минимального, но полезного контура.
Пример стартового набора для компаний с опорой на продажи
Продажи
отгрузки производителя (sell-in);
продажи партнёров / дистрибьюторов (sell-out);
POS-данные (off-take), если доступны.
Запасы
остатки на складах производителя;
остатки на складах дистрибьюторов;
по возможности — остатки по ключевым торговым точкам.
Мастер-данные
номенклатура (SKU, бренд, категория, упаковка);
клиенты и торговые точки (канал, формат, регион, город, геолокация);
организационная структура (регионы, команды, подразделения).
Данные полевого персонала (если есть)
визиты, маршруты, задачи, фото, промоактивности.
Главное — чтобы этот набор:
поступал регулярно;
проходил базовый контроль качества;
был закреплён за конкретными владельцами.
4. Типовая архитектура: от источников до отчётов
Схематично зрелая архитектура выглядит так:
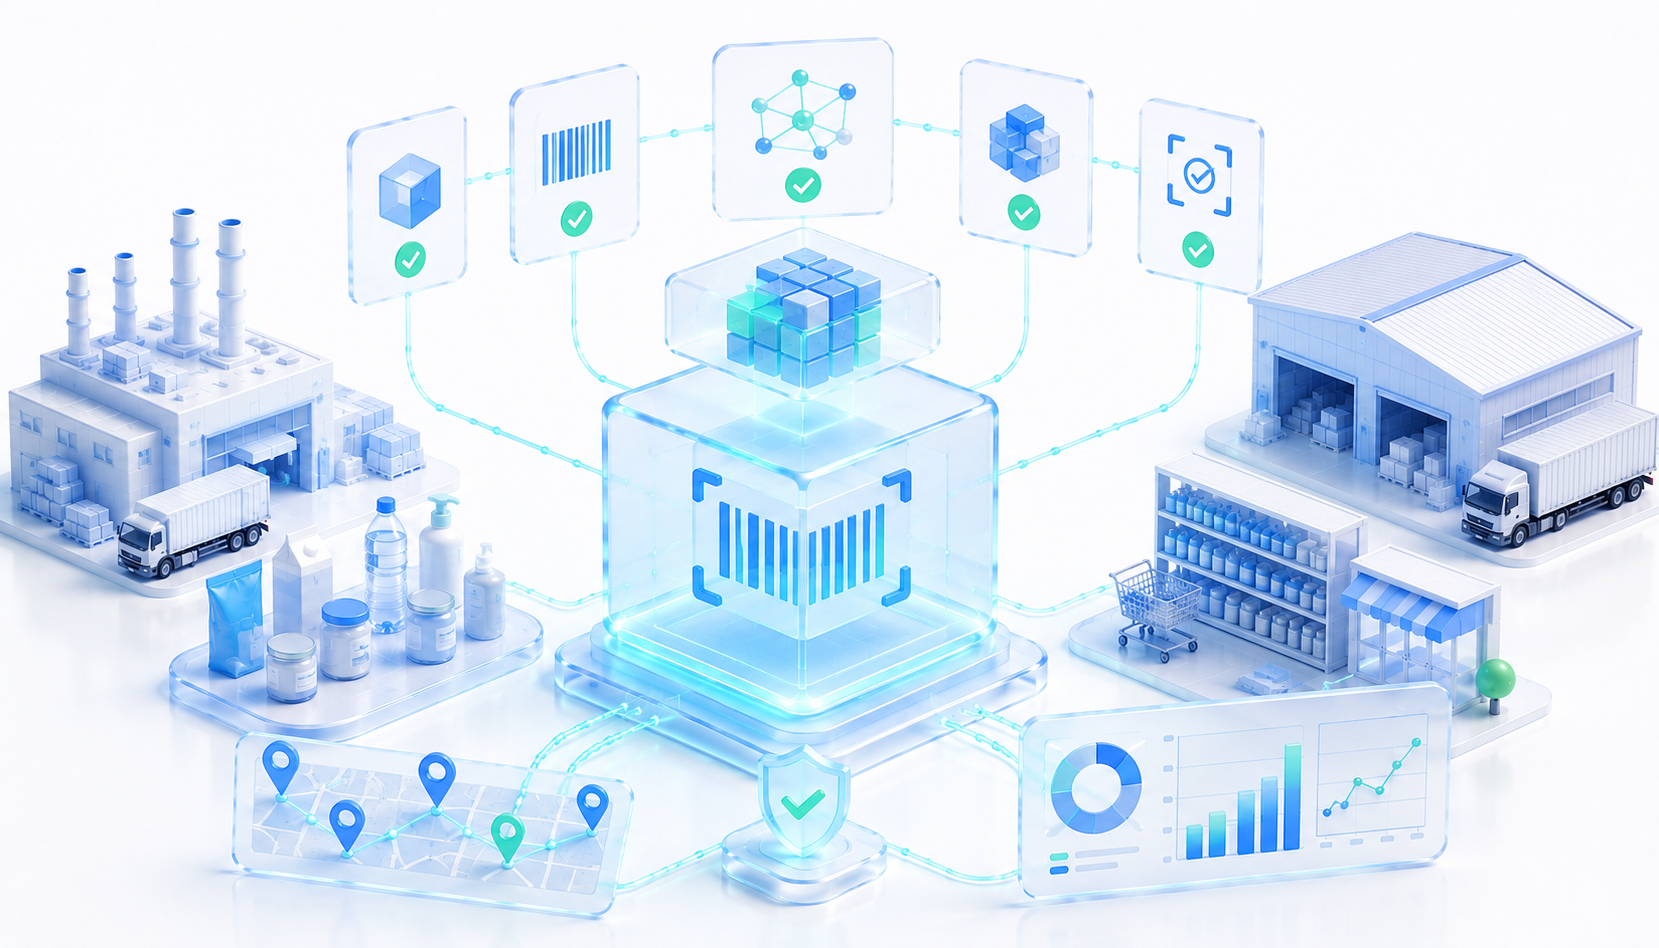
Источники → ETL / ELT → (Data Lake) → DWH → витрины → OLAP / BI
4.1. Источники данных
ERP, бухгалтерия, WMS;
CRM, системы лояльности;
DMS, SFA, порталы партнёров;
Excel-выгрузки;
веб-аналитика, рекламные кабинеты, логи и события.
Задача этого уровня — надёжно фиксировать оперативные процессы. Он не обязан быть удобным для аналитики, для этого и строится следующий слой.
4.2. Слой интеграции и ETL/ELT
На этом уровне:
данные попадают в staging в максимально сыром виде (но уже с базовыми проверками формата);
логируются объёмы и статусы загрузок, отслеживаются ошибки.
Если есть потоковые источники, используются стриминговые конвейеры (streaming ETL/ELT) — но логика остаётся той же: регулярность, качество, наблюдаемость.
настраиваются дашборды и отчёты под роли (директор по продажам, KAM, маркетинг, финансы, логистика);
реализуется self-service-аналитика для продвинутых пользователей.
Здесь уже не нужно разбираться в схеме БД — пользователь работает с понятными бизнес-полями и показателями.
5. Принципы надёжного ETL-конвейера
Даже идеальная модель DWH бессильна, если данные попадают в неё случайным образом.
5.1. Регулярность и предсказуемость
чёткое расписание загрузок;
SLA: когда данные за вчера считаются «официальными»;
учёт выходных, праздников, часовых поясов.
5.2. Контроль качества на уровне ETL
Примеры проверок:
заполнены ли обязательные поля;
нет ли отрицательных остатков там, где их быть не может;
цены в разумных диапазонах;
структура и формат файлов / сообщений соответствуют ожиданиям.
Ошибка не должна «тихо» попадать в DWH — она должна быть либо исправлена, либо зафиксирована и заблокирована.
5.3. Логирование и мониторинг
лог по каждому шагу: объёмы, статус, длительность, ошибки;
технический дашборд состояния ETL-процессов;
уведомления ответственным при сбоях.
5.4. ETL-пайплайны и оркестрация
Современные ETL/ELT-решения строятся как набор пайплайнов:
каждый пайплайн описывает последовательность шагов (jobs);
над ними есть оркестратор, который отслеживает зависимости, расписание, повторы;
пайплайны версионируются как код, с возможностью отката.
6. Проектирование DWH: практичные принципы
6.1. Звёздная схема (star schema)
Суть:
факт — таблица событий (продажа, визит, остаток);
измерения — справочники (время, продукт, клиент, регион, канал).
Плюсы:
понятная структура;
удобство для OLAP и BI;
хорошая производительность при правильной индексации.
6.2. Медленно изменяющиеся измерения (SCD)
Измерения меняются не мгновенно (магазин сменил формат, клиент перешёл в другой сегмент), и нужно решить, что делать с историей:
SCD Type 1 — переписываем историю (как будто «так было всегда»);
SCD Type 2 — храним версии (видно, что было до и после изменения).
Для управленческой и финансовой аналитики чаще нужен второй подход, иначе история «плывёт».
6.3. Регламенты и документация
Необходимы:
глоссарий показателей (что именно считается «выручкой», «объёмом», «маржой» в разных контекстах);
описание витрин и кубов;
регламент изменения модели (кто может менять, как согласовывать, как тестировать).
Иначе через год BI-отчёты разных подразделений начнут расходиться, и никто не поймёт, у кого «правильные» цифры.
7. OLAP и BI: от отчётности к управленческому инструменту
7.1. Чем OLAP-куб отличается от статичного отчёта
В статичном отчёте:
жёстко задан набор колонок и фильтров;
чтобы добавить новый срез, нужно переделывать отчёт.
В OLAP:
пользователь сам управляет срезами (slice & dice);
проваливается по иерархиям (drill-down: Год → Квартал → Месяц → День → ТТ);
комбинирует измерения по ситуации.
7.2. BI как единое пространство решений
В зрелой BI-среде:
есть официальные дашборды для топ-менеджмента;
есть аналитические витрины для экспертного анализа;
есть self-service BI в рамках общих правил и общих справочников.
Ключевой принцип — все смотрят на одну согласованную модель данных из одного DWH. Когда модель данных согласована, отчеты по продажам сетей становятся не отдельной выгрузкой, а управляемым слоем аналитики с проверяемыми источниками.
8. Управление данными как процесс: Data Governance
Архитектура данных не заработает без процессов и ответственных.
8.1. Роли
Data Owner — бизнес-владелец данных (например, директор по продажам за данные о продажах).
Data Steward — отвечает за качество и правила работы с данными в своей области.
Команда DWH / BI:
архитекторы хранилища;
инженеры данных (data engineers), которые строят и поддерживают ETL/ELT-процессы;
аналитики данных (data analysts), которые разрабатывают витрины и отчёты;
при наличии — специалисты по данным (data scientists), которые используют данные для моделей и продвинутой аналитики.
регулярный цикл «данные → аналитика → решения → действия → обратная связь».
При работе с Big Data добавляются:
каталог данных (data catalog) — описание наборов в Data Lake и DWH;
правила работы с чувствительными данными.
В итоге данные становятся отдельным управляемым активом, а не побочным продуктом ИТ.
9. Типичные ошибки проектов по данным
Нет общего языка Разные люди по-разному понимают, что такое «выручка», «клиент», «активная торговая точка».
Попытка сделать всё сразу Стратегия есть, рабочего контура нет. Через год есть презентации, но нет устойчивых инструментов.
Нет MDM и контроля качества Дубли клиентов и ТТ, разные коды SKU, некорректные цены. Аналитика строится на неустойчивой основе.
BI без DWH и ETL/ELTBI подключают напрямую к десяткам источников. Возникает избыточная сложность сопровождения и противоречивые цифры.
Данные не связаны с действиями Отчёты есть, но:
не определено, кто и как на них реагирует;
нет связи с операционными системами (CRM, DMS, SFA и др.).
Проект живёт только в ИТ Бизнес не вовлечён, владельцы данных не назначены, ответственность размазана.
Фокус только на Big Data и технологиях Разворачивается Data Lake, стриминговые конвейеры, но нет базового порядка в мастер-данных и DWH. В результате появляются просто большие, но малоуправляемые данные.
10. Мини-дорожная карта: как двигаться к зрелой архитектуре данных
ограниченное число, но максимально полезные отчёты;
закрепите их как официальный источник управленческой отчётности.
Параллельно выстраивайте MDM и Data Governance
назначьте владельцев данных;
ведите глоссарий;
договоритесь о правилах качества.
Расширяйте контур и усложняйте аналитику
добавляйте новые предметные области;
подключайте более сложные модели: прогнозирование, оптимизацию, Big Data-аналитику и машинное обучение.
11. Итог: что важно запомнить
Зрелая архитектура данных — это не только DWH и BI. Это:
общие понятия и единый язык;
устойчивый ETL/ELT-конвейер;
качественные мастер-данные;
понятные роли и процессы управления данными.
Начинать имеет смысл с небольшого, но рабочего контура и быстро показывать бизнесу пользу. Тогда архитектура данных перестаёт быть «большим проектом где-то в ИТ» и становится частью повседневного управления компанией.
FAQ: ключевые термины и вопросы
Что такое DWH простыми словами?
DWH (Data Warehouse) — это отдельное хранилище данных, куда стекается информация из всех основных систем компании. Там она очищается, приводится к единому формату и хранится так, чтобы по ней можно было быстро и надёжно строить отчёты и аналитику.
Чем DWH отличается от обычной базы данных?
Операционная база (OLTP) оптимизирована под быстрый ввод и изменение транзакций (заказы, платежи, документы).DWH оптимизирован под чтение и анализ:
хранит историю;
поддерживает сложные запросы и отчёты;
содержит согласованную модель данных для всей компании.
Что такое ETL-процесс?
ETL (Extract–Transform–Load) — это:
Extract — получить данные из источников (ERP, CRM, DMS, SFA, файлы и т.д.);
Transform — очистить, стандартизировать, обогатить, сопоставить со справочниками;
Load — загрузить в хранилище данных (DWH) или витрины.
Что такое ETL-пайплайн?
ETL-пайплайн — это реализованный конвейер ETL:
цепочка шагов (jobs) от чтения и проверки до загрузки в DWH;
управляемое расписание и порядок выполнения;
логирование и контроль ошибок.
Обычно в компании существует множество ETL-пайплайнов для разных предметных областей и источников.
Чем ETL отличается от ELT?
При ETL данные сначала трансформируются вне хранилища (например, на ETL-сервере), а затем загружаются в DWH.
При ELT данные сначала загружаются в DWH или Data Lake, а затем трансформации выполняются внутри самого хранилища.
ELT чаще применяют, когда хранилище достаточно мощное (облако, MPP-решения) и выгодно использовать его ресурсы для вычислений.
Что такое OLAP-куб?
OLAP-куб — это многомерная структура, в которой:
измерения — время, товары, клиенты, регионы, каналы;
меры — продажи, маржа, остатки, визиты, KPI.
Куб позволяет быстро строить отчёты в разных разрезах и проваливаться до нужного уровня деталей.
Чем BI отличается от обычной отчётности?
BI — это не один отчёт, а платформа, которая:
предоставляет интерактивные дашборды;
даёт конструкторы отчётов;
опирается на единую модель данных и согласованные KPI.
Главное отличие — BI работает на общей архитектуре данных, а не на разрозненных выгрузках.
Что такое MDM и почему он важен?
MDM (Master Data Management) — управление мастер-данными: товары, клиенты, торговые точки, каналы, иерархии.
MDM:
устраняет дубли и противоречия в справочниках;
обеспечивает единую базу для всех систем;
повышает доверие к любой аналитике и отчётности.
Что такое Big Data простыми словами?
Big Data — это большие, быстро меняющиеся и разнообразные данные:
большие объёмы (миллиарды записей);
высокая скорость поступления (стриминг, события);
множество форматов (таблицы, JSON, логи, медиаданные).
Для работы с ними используют Data Lake, масштабируемые хранилища и потоковые конвейеры обработки.
Что такое Data Lake?
Data Lake — это хранилище сырых данных, куда складываются данные из разных источников «как есть» (без жёсткой схемы):
удобно для Data Science, прототипирования, работы с полуструктурированными данными;
часто используется вместе с DWH: Data Lake хранит всё в исходном виде, DWH — структурированную часть для управленческой аналитики.
Нужен ли DWH небольшой компании?
Если есть одна учётная система и несколько простых отчётов, DWH может быть избыточен.
Но как только:
появляется несколько источников данных;
используются регулярные Excel-выгрузки;
важна единая управленческая отчётность,
DWH и системный подход к данным начинают экономить время, деньги и уменьшать риск ошибок.
Если вы хотите обсудить, на каком этапе развития архитектуры данных находится ваша компания и с чего лучше начать, команда ARK готова провести короткую консультацию и поделиться практическими примерами. Если приоритет связан с каналом, отдельной точкой старта может стать управление продажами дистрибьюторов, где особенно быстро проявляется ценность единой архитектуры данных.
Получить консультацию
Другие новости
14.08.2026
Как мотивировать дистрибьютора передавать качественные данные: KPI, бонусы и модель сотрудничества
Почему дистрибьютор иногда скрывает клиентские данные, спорит с KPI и пытается обойти бонусную систему? Разбираем, как учитывать переговорную силу производителя, защищать коммерческую информацию, ставить реалистичные цели и превращать обмен данными в инструмент роста продаж и снижения затрат для обеих сторон.
Статья
Дистрибуция
03.07.2026
Outlet universe в FMCG: как создать эталонную базу торговых точек, убрать дубли и не терять охват
Практическое руководство по outlet universe для FMCG: как построить эталонную базу торговых точек, договориться с дистрибьюторами о данных, настроить дедупликацию и перестать терять реальный охват из-за дублей, устаревших адресов и локальных кодов.
outlet universe
эталонная база торговых точек
дедупликация торговых точек
данные дистрибьюторов
охват FMCG
03.07.2026
Учет POSM в FMCG: как контролировать торговое оборудование и рекламные материалы от склада до торговой точки
Разбираем, как управлять POSM в FMCG: от закупки, складского учета и выдачи в поле до установки в торговой точке, фотофиксации, инвентаризации, ремонта, списания и аналитики эффективности.
FMCG
POSM
Учет торгового оборудования
Рекламные материалы
Автоматизация полевых продаж
03.07.2026
GTIN, EAN, GS1, SKU и "Честный знак": как настроить товарные идентификаторы, маппинг продукции и сквозную аналитику в FMCG
Разбираем, как не запутаться в товарных идентификаторах, чем GTIN отличается от SKU, зачем нужен EAN, как "Честный знак" связан с карточкой товара и почему без управляемого маппинга продукции производитель не получает надежную аналитику по продажам, остаткам, планам и дистрибуции.
GTIN
EAN
GS1
Честный знак
Маппинг товаров
Мастер-данные
FMCG
05.06.2026
Data Quality в FMCG: как проверить качество данных по торговым точкам, SKU, дистрибьюторам и отчетности
Разбираем, как выстроить проверку качества данных в FMCG: от справочников торговых точек и SKU до отчетности дистрибьюторов, DMS, SFA, MDM и BI. Показываем, какие правила, KPI и процессы помогают бизнесу перестать спорить о цифрах и начать управлять рынком на основе доверенных данных.
Статья
Анализ
Мастер-данные
Мы используем файлы cookies для улучшения работы сайта и анализа сетевого трафика. Подробнее — в Политике. Продолжая пользоваться сайтом, вы даёте согласие на использование файлов cookies.
Наш сайт собирает статистику посещения и данные посетителей сайта с помощью сервисов аналитики. Подробнее – в Политике.


 консультацию